Le problème lié au flux de travail des développeurs dont personne ne parle
Le développement logiciel moderne n'a jamais été aussi performant — et pourtant, les équipes passent encore un temps surprenant à se débattre avec leurs outils. Le problème ne réside pas dans les outils eux-mêmes, mais dans les frictions qui existent entre eux.
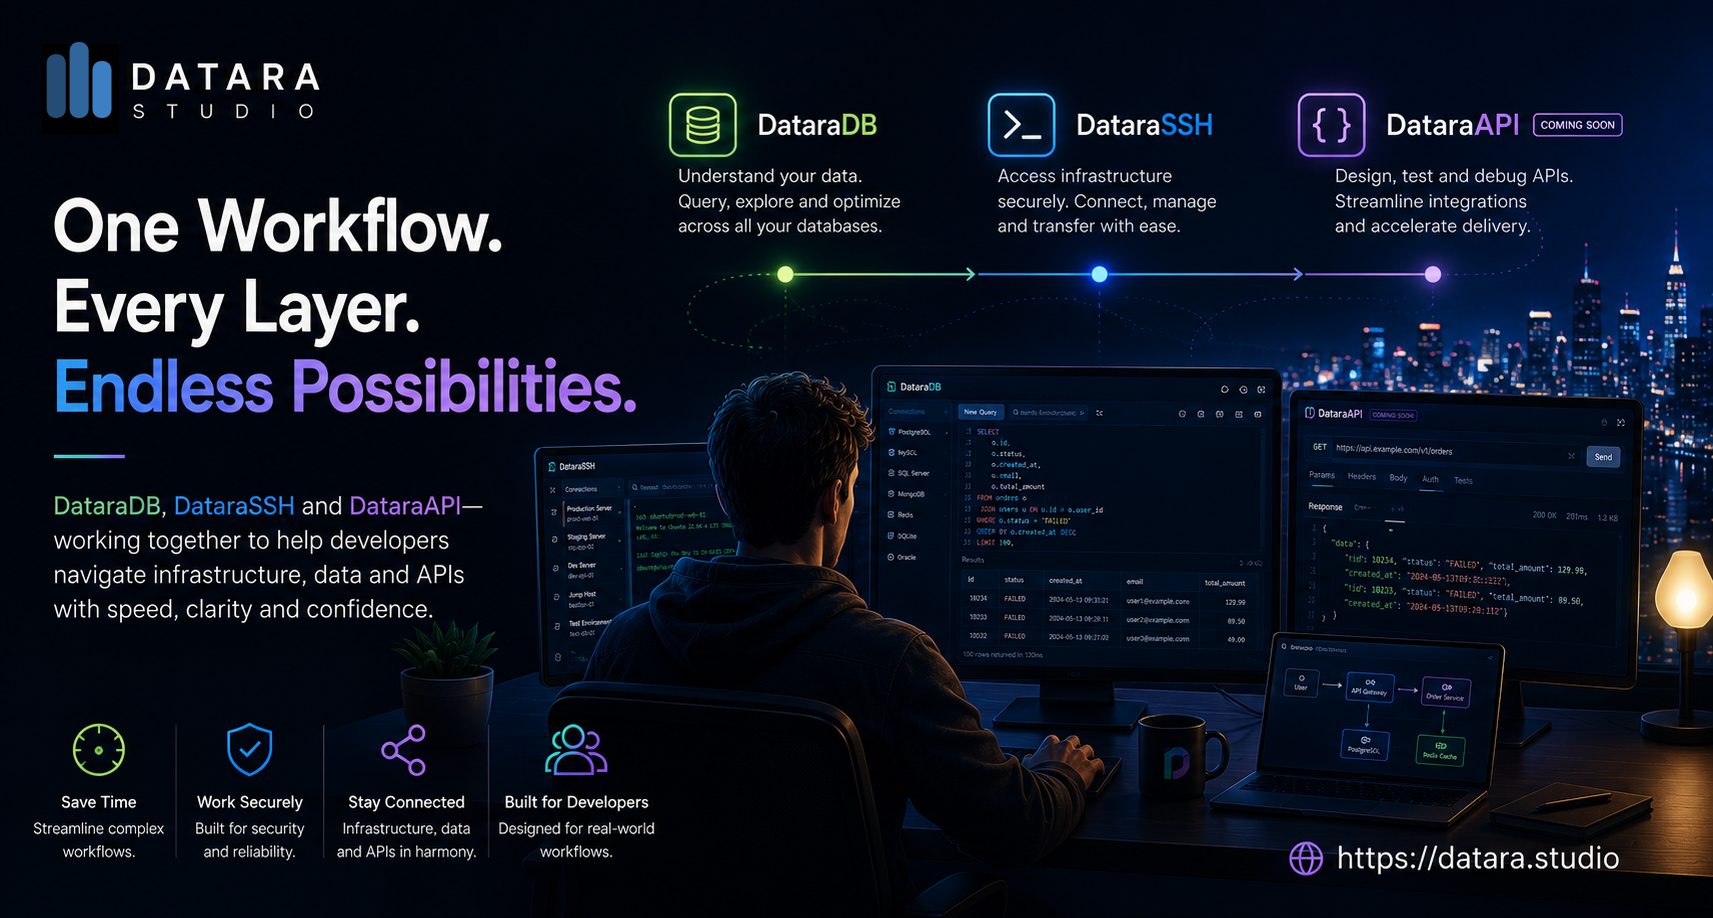
Le développement logiciel moderne n'a jamais été aussi performant.
Un développeur travaillant depuis son bureau à domicile dispose aujourd’hui d’une puissance de calcul, d’un nombre de frameworks, de services cloud, de bases de données et de possibilités d’automatisation bien supérieurs à ceux dont disposaient des services d’ingénierie entiers il y a vingt ans. L’écosystème des outils a explosé, l’IA fait désormais partie intégrante des workflows quotidiens, et la mise en place d’une infrastructure mondiale ne prend plus que quelques minutes, et non plus plusieurs mois.
Pourtant, malgré tous ces progrès, de nombreuses équipes d’ingénieurs passent encore un temps surprenant à se battre avec leurs outils.
Non pas parce que ces outils sont mauvais. La plupart sont excellents pour résoudre des problèmes isolés. Le défi réside dans le fait que les workflows de développement modernes impliquent rarement un seul problème.
Un développeur enquêtant sur un problème en production peut commencer par examiner les journaux d’application sur un serveur distant. Cela l’amène à effectuer une requête sur la base de données. La requête révèle des données inattendues. Le développeur doit alors inspecter une réponse d’API, valider des charges utiles, tracer un appel de service, examiner une migration, comparer des schémas entre différents environnements et peut-être déployer un correctif.
Chaque tâche prise individuellement est simple.
C’est lors des transitions que les frictions apparaissent.
Une application pour SSH. Une autre pour les bases de données. Une autre pour les tests d’API. Une autre pour les transferts de fichiers. Une autre pour les tunnels. Une autre pour la documentation. Une autre pour la visibilité sur le déploiement.
À la fin de la journée, les ingénieurs ont passé autant de temps à passer d’un outil à l’autre qu’à résoudre le problème lui-même.
Le secteur parle souvent de réduire la complexité au sein des systèmes. On accorde beaucoup moins d’attention à la réduction de la complexité entre les systèmes.
Cette distinction est importante.
Le coût du changement de contexte
Le changement de contexte est devenu l’un des facteurs de perte de productivité les plus sous-estimés en génie logiciel.
Le problème ne réside pas simplement dans le fait d’ouvrir plusieurs applications. Chaque outil introduit sa propre interface, son modèle d’authentification, ses conventions de workflow, sa terminologie, ses raccourcis et ses hypothèses opérationnelles.
Un ingénieur enquêtant sur un problème de base de données peut passer d’une console cloud à un client SSH, puis à un client de base de données, avant de se rendre sur une plateforme de test d’API pour finalement revenir à un IDE. Chaque transition oblige le cerveau à recharger le contexte.
Ce coût s’accumule au fil du temps.
Cela devient particulièrement visible lors de la gestion des incidents, lorsque les équipes sont sous pression et que chaque minute compte. Un problème en production se présente rarement de manière bien délimitée, confiné aux limites d’un seul système. Le plus souvent, il touche simultanément les bases de données, l’infrastructure, les API, les services d’authentification, les couches de stockage et les environnements de déploiement.
Malheureusement, l’écosystème des outils a encore tendance à traiter ces domaines comme des mondes distincts.
Ce n’est pas le cas des développeurs.
L’infrastructure, les données et les API ne sont plus des disciplines distinctes
Il fut un temps où les équipes d’infrastructure géraient les serveurs, les administrateurs de bases de données s’occupaient des bases de données et les développeurs se concentraient principalement sur le code des applications.
Ces frontières ont largement disparu.
On attend souvent aujourd’hui d’un développeur qu’il maîtrise l’infrastructure cloud, les réseaux, les bases de données, les contrôles de sécurité, l’automatisation des déploiements, l’orchestration des conteneurs, l’observabilité et les workflows assistés par l’IA.
L’essor de l’ingénierie de plateforme et du DevOps a accéléré cette convergence.
En conséquence, les développeurs naviguent chaque jour de plus en plus entre trois domaines opérationnels :
L’infrastructure. Les données. La connectivité.
L’infrastructure donne accès aux environnements. Les données fournissent des informations sur ce qui se passe réellement. Les API relient les services entre eux.
Lorsqu’un problème survient, les développeurs se contentent rarement d’examiner un seul de ces domaines de manière isolée. Ils examinent les trois.
Un exemple concret
Imaginons qu’un client signale que des commandes échouent de manière intermittente sur une plateforme de commerce électronique.
Le premier réflexe peut être d’inspecter les journaux de l’application. Un ingénieur ouvre une session SSH vers le serveur de production et commence à examiner l’activité du système.
Rien de flagrant n’apparaît.
L’attention se porte alors sur la base de données. L’interrogation de la table des commandes révèle plusieurs transactions incomplètes. Une analyse plus approfondie montre que des enregistrements sont créés mais ne sont pas entièrement traités.
À ce stade, l’attention se déplace à nouveau.
Le développeur doit inspecter l’API chargée de soumettre ces commandes. Les requêtes sont rejouées. Les réponses sont validées. Les en-têtes sont vérifiés. Les jetons d’authentification sont examinés. Des charges utiles de test sont générées et comparées.
Finalement, la cause première est identifiée.
Une modification subtile du contrat de l’API a introduit un cas limite inattendu qui s’est propagé à travers la pile applicative et s’est finalement traduit par des enregistrements de base de données incomplets.
Remarquez un point important. Le problème n’a jamais été purement un problème d’infrastructure. Il n’a jamais été purement un problème de base de données. Ce n’a jamais été un problème purement lié à l’API. Il s’agissait d’un problème de workflow opérationnel. Et ce type de situation devient de plus en plus courant.
L’essor des outils opérationnels
La prochaine génération d’outils de développement devrait moins se concentrer sur des fonctionnalités isolées et davantage sur la continuité opérationnelle.
Les développeurs n’ont pas nécessairement besoin de plus d’outils. Ils ont besoin de moins d’interruptions dans leurs workflows.
C’est là que les plateformes opérationnelles deviennent intéressantes. Plutôt que de traiter les bases de données, l’infrastructure et les API comme des activités indépendantes, les outils modernes peuvent commencer à reconnaître que ces systèmes sont des éléments étroitement liés au sein d’un même flux de travail.
C’est cette philosophie qui sous-tend Datara Studio.
DataraDB : comprendre la couche de données
DataraDB a été conçu à partir d’un constat simple. Les applications modernes génèrent plus de données que jamais, mais la compréhension de ces données reste souvent étonnamment difficile.
Les développeurs travaillent régulièrement avec PostgreSQL, MySQL, SQL Server, Oracle, SQLite, Redis et MongoDB. Ils comparent des schémas, examinent les migrations, résolvent les problèmes de performances, génèrent de la documentation et recourent de plus en plus à l’IA pour accélérer le développement des requêtes.
DataraDB intègre ces flux de travail dans un environnement moderne et hautement performant, axé sur le travail d’ingénierie pratique au quotidien plutôt que de se contenter de servir de navigateur de base de données.
L’objectif n’est pas simplement d’exécuter des requêtes. L’objectif est de comprendre les systèmes. Car lorsqu’un problème survient, c’est souvent la base de données qui en révèle les causes en premier.
DataraSSH : accéder à la couche d’infrastructure
Bien sûr, les données existent rarement de manière isolée. Les applications résident sur des serveurs, dans des conteneurs, sur des plateformes cloud, dans des machines virtuelles et dans des environnements périphériques.
Cela signifie que les développeurs ont toujours besoin d’un accès fiable à l’infrastructure. SSH reste l’une des technologies les plus importantes de l’informatique moderne, car l’accès distant sécurisé continue de sous-tendre les flux de travail opérationnels dans pratiquement tous les secteurs.
DataraSSH a été créé pour moderniser cette expérience. Plutôt que de traiter SSH comme un utilitaire autonome, DataraSSH est conçu comme un espace de travail opérationnel pratique pour les développeurs et les équipes d’infrastructure qui ont besoin de connexions sécurisées, de redirection de ports, de transferts de fichiers, d’hôtes relais et de gestion d’environnement, sans complexité inutile.
L’infrastructure doit être facile d’accès. Et non difficile à exploiter.
DataraAPI : compléter le flux de travail
DataraAPI sera bientôt disponible sur la plateforme Datara Studio.
Si DataraDB aide les développeurs à comprendre les données et que DataraSSH leur permet d’accéder à l’infrastructure, DataraAPI est conçu pour les aider à comprendre la connectivité.
Les applications modernes communiquent de plus en plus via des API. Elles sont au cœur des intégrations, des services internes, des écosystèmes de partenaires, des applications mobiles, des plateformes SaaS, des systèmes d’IA et des workflows d’automatisation.
Pourtant, les tests, la validation, la documentation et la gestion du cycle de vie des API restent souvent déconnectés des environnements et des bases de données avec lesquels elles interagissent.
DataraAPI vise à rapprocher ces flux de travail. En effet, les développeurs examinent rarement les API sans finir par toucher à l’infrastructure ou aux données. Et ils examinent rarement l’infrastructure ou les données sans finir par toucher aux API.
La plateforme de flux de travail opérationnels
Pris individuellement, DataraDB, DataraSSH et DataraAPI résolvent des problèmes courants. Ensemble, ils reflètent une évolution plus large au sein de l’ingénierie logicielle.
Le secteur s’oriente vers des workflows opérationnels plutôt que vers des catégories d’outils isolées. Les développeurs ne se contentent plus d’écrire du code. Ils naviguent dans des systèmes interconnectés qui englobent l’infrastructure, les bases de données, les API, les environnements cloud, les périmètres de sécurité et, de plus en plus, des workflows assistés par l’IA.
Les outils qui s’imposeront dans les années à venir seront probablement ceux qui tiendront compte de ces réalités et réduiront les frictions entre elles. Non pas parce que les ingénieurs ont besoin de plus de fonctionnalités, mais parce qu’ils ont besoin de plus de continuité.
L’avenir de la productivité des développeurs ne réside peut-être pas dans la création, de manière isolée, de meilleurs clients de bases de données, de meilleurs clients SSH ou de meilleurs outils API. Il réside peut-être plutôt dans la mise en place d’un meilleur flux de travail opérationnel englobant ces trois éléments.